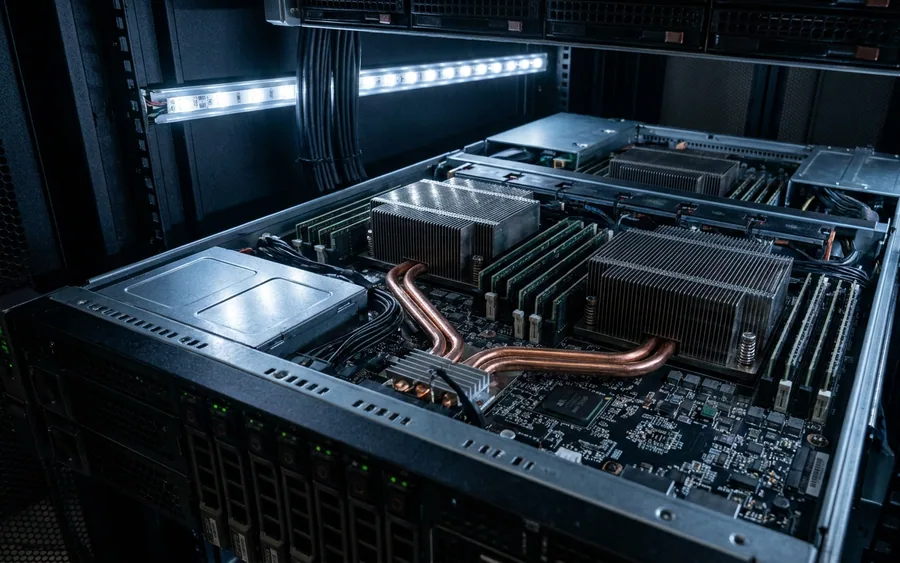
Машинне навчання міжатомних потенціалів (MLIP) дозволяє моделювати молекулярні системи значно швидше за методи квантової механіки на зразок теорії функціонала густини (DFT). Проте симуляції атомарного рівня чутливі до накопичення похибок при розрахунку сил, через що більшість таких моделей змушені виконувати інференс в одинарній точності (FP32), не використовуючи переваги низькоточних операцій тензорних ядер сучасних GPU Nvidia.
Команда Nvidia показала спосіб подолання цього бар'єра за допомогою емуляції FP32 через тензорні ядра без перенавчання нейромереж чи зміни їхньої архітектури. Підхід полягає в декомпозиції операндів FP32 на компоненти нижчої точності, обчисленні перехресних добутків на Tensor Core та їх подальшому накопиченні у FP32.
Реалізація для архітектур Blackwell та Ampere
Nvidia протестувала дві стратегії емуляції:
- BF16x9 на чипах Blackwell: кожен операнд FP32 розкладається на три компоненти BF16 зі шкалюванням, що формує дев'ять попарних добутків. У бібліотеці cuBLAS (для чипів з compute capability 10.0 або 10.3) функціонал доступний «з коробки» через змінну середовища
CUBLAS_EMULATE_SINGLE_PRECISION=1або відповідні прапорці математичного режиму, що не вимагає змін у коді моделей PyTorch. - TF32x3 на чипах Ampere: операнд ділиться на провідний та залишковий компоненти TF32 без коефіцієнтів масштабування. Обчислюються три добутки (провідний на провідний та два перехресні із залишковими), тоді як найменший залишковий добуток відкидається. Реалізація спирається на оператор
cutlass::arch::OpMultiplyAddFastF32у бібліотеці CUTLASS C++, замінюючи стандартні шариnn.Linearна кастомні.
Результати тестів на моделі PET
Методики перевірили на трансформерній моделі Point Edge Transformer (PET), розробленій Lab COSMO в EPFL. Оцінювалися контрольні точки PET-MAD на 26 млн параметрів (для систем зі 192 та 17 280 атомів води) і на 255 млн параметрів.
- На графічних процесорах Blackwell (B300): метод BF16x9 прискорив великі матричні множення (GEMM) у 2,2–2,5 раза для навантаження на 17 280 атомів, а повний крок молекулярної динаміки (MD) — до 1,7 раза у режимі
performant. - На процесорах Ampere (A100): кастомний шар TF32x3 забезпечив прискорення GEMM у 1,7–1,9 раза, а повного MD-кроку — у 1,5 раза для великої системи. Водночас однопрохідний TF32 хоч і показував більший приріст, спричиняв деградацію точності та розбіжність сил.
Фізична стабільність та релаксація структури
Під час тестів гладкості потенціальної енергії молекули CO на поверхні платини Pt(111) та енергетичного дрейфу в симуляціях NVE TF32x3 зберіг стабільність і плавність кривих, близьку до базової FP32.
При тестуванні структурної релаксації зрізу сплаву Кантора (539 атомів) за допомогою оптимізатора FIRE2 в NVIDIA ALCHEMI Toolkit підхід TF32x3 зійшовся до заданої похибки ($1.0 \times 10^{-3}$ еВ/Å) за 218–222 кроки (проти 218 кроків у FP32), скоротивши час кожного кроку в 1,5 раза. Для порівняння, стандартний однопрохідний режим TF32 не зміг досягти збіжності навіть після подвоєння ліміту до 1000 кроків.
Реклама · cv-finder.com
Створіть резюме з ШІ безкоштовно на CV-Finder
Готове до відгуку CV за кілька хвилин: шаблони, AI-асистент і перевірка ATS.
Що це означає для розробників
Розробники наукових моделей та MLIP можуть прискорити виконання інференсу у FP32 без зміни архітектури чи повторного навчання ваг. На нових GPU Blackwell для PyTorch достатньо увімкнути прапорець емуляції в cuBLAS, а для архітектур Ampere/Hopper доступне використання оператора CUTLASS у кастомних лінійних шарах.
Ключові факти
-
Метод BF16x9 на чипах Blackwell прискорює операції GEMM у 2,2–2,5 раза і крок молекулярної динаміки до 1,7 раза.
-
Метод TF32x3 на Nvidia A100 дає прискорення GEMM у 1,7–1,9 раза та повного кроку симуляції у 1,5 раза.
-
Підтримка BF16x9 інтегрована в cuBLAS і вмикається прапорцем CUBLAS_EMULATE_SINGLE_PRECISION=1 без модифікації коду моделі.
-
TF32x3 зберіг фізичну стабільність траєкторій та успішну збіжність релаксації сплаву з 539 атомів, тоді як звичайний одноетапний TF32 призвів до розбіжності.
Додайте Voydevich.com у бажані джерела Google, щоб частіше бачити наші новини в пошуку.
Джерело
NVIDIA Technical BlogAnoushka Bhutani
Unlocking Tensor Core Performance for Machine Learning Interatomic Potentials29 жовтня 2026 · оновлено 29 жовтня 2026
Реклама · cv-finder.com
Створіть резюме з ШІ безкоштовно на CV-Finder
Готове до відгуку CV за кілька хвилин: шаблони, AI-асистент і перевірка ATS.
Попередні статті
Nvidia CUDA 13.4 додає ізоляцію памʼяті під час спільного використання GPU в Kubernetes
Реліз CUDA 13.4 забезпечує прозоре обмеження відеопамʼяті для застосунків, а новий оператор gpu-fractioning інтегрує ці можливості в кластери Kubernetes.
Elektrobit та Microchip спрощують розробку ПЗ на базі AUTOSAR для автоіндустрії
Компанії обʼєднали автомобільні платформи Microchip та інструменти Elektrobit, запропонувавши інтеграцію MCAL та автоматизацію на базі підходу integration-as-code.
Nvidia Mission Control 2.5 додає автономне відновлення для Kubernetes
Nvidia розширила механізм автономного виявлення та відновлення після збоїв на Kubernetes-кластери під керуванням Run:ai.