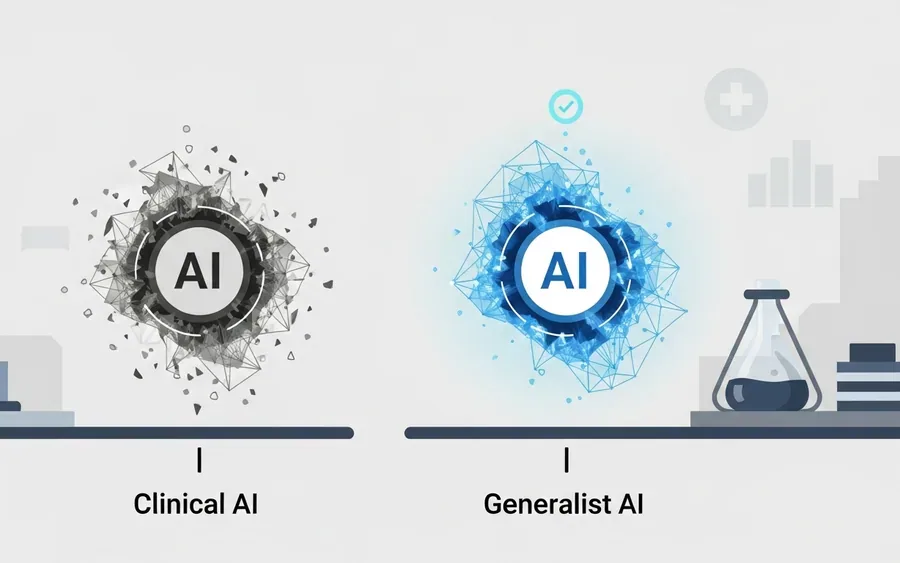
Сотні тисяч американських лікарів використовують клінічні великі мовні моделі (LLM), які компанії, такі як OpenEvidence, Doximity та UpToDate, позиціонують як протиотруту від галюцинацій, притаманних загальним моделям від великих технологічних компаній.
Порівняльне дослідження
Донедавна було мало досліджень, які б безпосередньо порівнювали ці два типи моделей. Проте цього літа відбулося значне пряме зіставлення. Дослідники з NYU Langone Health протестували загальні та клінічні моделі, включно з OpenEvidence та UpToDate Expert AI, на трьох наборах клінічних питань.
Несподівані результати
Отримані дані, опубліковані в Nature Medicine у червні, показали, що клінічний ШІ працював гірше, ніж загальні моделі. Ці результати викликали значний резонанс у спільноті медичного ШІ.
Реакція спільноти
Віцепрезидент з ШІ та новітніх технологій Kaiser Permanente на LinkedIn зазначив, що він "ніколи не бачив, щоб одна стаття викликала таку реакцію в спільноті медичного ШІ". Хоча висновки дослідження, як і будь-яка наукова робота, підлягають інтерпретації та дебатам, багато онлайн-реакцій сприйняли їх як чітку перемогу для загальних передових моделей.
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Що це означає для розробників
Це дослідження вказує на те, що розробникам клінічних LLM, можливо, варто переглянути свої підходи, оскільки загальні моделі показали кращі результати. Для розробників загальних LLM це може бути підтвердженням їхньої ефективності навіть у спеціалізованих галузях, таких як медицина.
Ключові факти
-
Сотні тисяч лікарів у США використовують клінічні великі мовні моделі (LLM).
-
Компанії, такі як OpenEvidence, Doximity та UpToDate, просувають клінічні LLM як альтернативу загальним моделям, схильним до галюцинацій.
-
Дослідники з NYU Langone Health провели порівняльне дослідження загальних та клінічних моделей (включно з OpenEvidence та UpToDate Expert AI) на трьох наборах клінічних питань.
-
Результати дослідження, опубліковані в Nature Medicine у червні, показали, що клінічний ШІ працював гірше, ніж загальні моделі.
-
Ці висновки викликали бурхливу реакцію в спільноті медичного ШІ.
Додайте Voydevich.com у бажані джерела Google, щоб частіше бачити наші новини в пошуку.
Джерело
STATKatie Palmer
Clinical chatbots are taking medicine by storm. Should doctors trust them?29 липня 2026
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Попередні статті

Вартість локальних LLM на Apple Silicon: 120-мільярдна модель дешевша за 27-мільярдну
Дослідження виявило, що на Apple Silicon вартість запуску локальних великих мовних моделей не залежить від кількості параметрів, а від пропускної здатності та архітектури моделі.
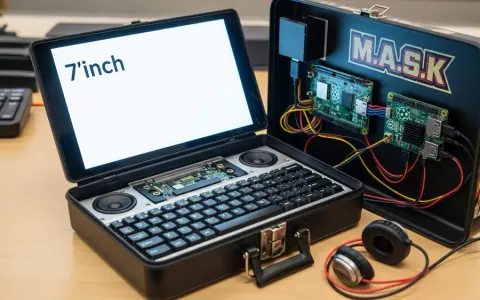
Ланчбокс M.A.S.K. перетворили на кібердек з локальним LLM
Ентузіаст створив портативний кібердек, вбудувавши Raspberry Pi 5 та 7-дюймовий сенсорний екран у вінтажний ланчбокс M.A.S.K. Пристрій працює з локальною 3-мільярдною моделлю LLM без підключення до інтернету.
Єврокомісія представила інституційний LLM та бенчмарк для мов ЄС
Європейська Комісія випустила відкриту велику мовну модель (LLM) та новий бенчмарк EU MMLU, розроблені для підтримки 24 офіційних мов ЄС та зміцнення європейського суверенного ШІ.
Наступні статті
Intuit Credit Karma використовує гібридний ШІ для точних фінансових рішень
Intuit Credit Karma відходить від загальних чат-ботів, впроваджуючи спеціалізовані ШІ-асистенти, що поєднують детерміновані фінансові розрахунки з генеративним ШІ.
Microsoft представила архітектуру маршрутизації LLM-трафіку для AI-агентів на AKS
Microsoft випустила еталонну архітектуру для маршрутизації трафіку AI-агентів на Azure Kubernetes Service, що оптимізує витрати та продуктивність за допомогою трирівневого підходу.
Haiku OS: Операційна система, що відмовилася стати Linux
Haiku OS, спадкоємиця BeOS, пропонує унікальний підхід до дизайну ОС, відрізняючись від Linux та інших систем, і є легкою та функціональною альтернативою.