Потенціал машинного навчання у діагностиці
Дослідження, представлене на зустрічі ADLM 2026 в Анахаймі, Каліфорнія, вказує на те, що машинне навчання (МН) може відігравати важливу роль у підвищенні точності стандартного аналізу крові. Цей аналіз використовується для діагностики рідкісних пухлин, що утворюються в надниркових залозах або поблизу них. Ці пухлини відомі як феохромоцитоми та парагангліоми (PPGL). Дослідження також підкреслює складність використання моделей МН у лабораторній медицині.
Проблема хибнопозитивних результатів
Плазмові вільні метанефрини є рекомендованим тестом першої лінії для виявлення PPGL, які спричиняють надмірне вироблення гормонів стресу в організмі. Неліковані PPGL можуть призвести до проблем із серцем, головного болю, високого кров'яного тиску та інших ускладнень. Хоча тест на метанефрини ефективно виявляє людей з PPGL, він менш ефективний у виключенні тих, хто не має цього стану. Це пов'язано з тим, що незначні підвищення метанефринів — метаболітів, отриманих з гормонів стресу — часто спостерігаються у пацієнтів без цих пухлин, що призводить до хибнопозитивних результатів.
Виявлення "ярликового навчання"
Дослідники протестували кілька алгоритмів МН, щоб оцінити, наскільки вони можуть підвищити точність, зменшуючи ймовірність хибнопозитивних результатів. Вони проаналізували дані 20 516 дорослих, які пройшли тестування на метанефрини в Медичному центрі Samsung між 2011 і 2024 роками. З 19 797 пацієнтів, які зрештою не мали PPGL, 25.2% продемонстрували підвищення метанефринів, що могло спричинити хибнопозитивний результат.
Початкові моделі машинного навчання показали, що поєднання результатів плазмових метанефринів зі структурованою клінічною інформацією з електронних медичних карт може покращити реальну дискримінацію. Співавтори дослідження Се-ун Ку та доктор Су-Юн Лі виявили, що інтеграція МН для оцінки відповідного клінічного контексту — включаючи біомаркери нирок та сечі, ліки пацієнтів та наявність інших захворювань — покращила ефективність тесту.
Однак, після подання початкових висновків, Ку та доктор Лі провели додаткові аналізи, щоб визначити, чи не використовували алгоритми МН будь-які "ярлики" у навчанні, які могли б призвести до помилок або упереджень. Додаткові аналізи на стійкість показали, що значна частина покращення пояснювалася "ярликовим навчанням" (shortcut learning) на основі інформативної відсутності даних. Іншими словами, хоча моделі МН, здавалося, покращували діагностичну точність, вони робили це, навчаючись тому, які подальші тести були призначені — що клініцисти роблять, коли вже підозрюють PPGL.
Важливість аудиту та валідації
Дослідження показує, що машинне навчання в лабораторній медицині слід оцінювати не лише за показниками ефективності, а й за тим, чи навчається модель передбачуваному клінічному сигналу. Зовнішня валідація та ретельний аудит для виявлення "ярликового навчання" є важливими. Се-ун Ку планує детально розглянути цей дослідницький проєкт під час своїх стендових та усних презентацій на ADLM 2026.
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Що це означає для розробників
Ця новина означає, що розробники, які створюють моделі машинного навчання для лабораторної медицини, повинні зосередитися на ретельній валідації та аудиті. Важливо переконатися, що моделі навчаються передбачуваному клінічному сигналу, а не покладаються на "ярликове навчання", яке може призвести до помилок або упереджень.
Ключові факти
-
Машинне навчання (МН) може покращити точність стандартного аналізу крові для діагностики рідкісних пухлин надниркових залоз (феохромоцитом та парагангліом).
-
Стандартний тест на метанефрини ефективно виявляє наявність пухлин, але часто дає хибнопозитивні результати через незначні підвищення метанефринів у пацієнтів без пухлин.
-
Дослідження проаналізувало дані 20 516 дорослих з Медичного центру Samsung (2011-2024), виявивши 25.2% хибнопозитивних результатів серед пацієнтів без пухлин.
-
Початкові моделі МН, що поєднували результати метанефринів з клінічною інформацією з електронних медичних карт, покращили діагностику.
-
Подальший аналіз виявив, що покращення значною мірою було результатом "ярликового навчання" (shortcut learning), коли МН моделі вчилися на замовленнях додаткових тестів, що вже вказувало на підозру клініцистів.
Додайте Voydevich.com у бажані джерела Google, щоб частіше бачити наші новини в пошуку.
Джерело
Association
Large-scale study points to potential -- and challenges -- of using machine learning as diagnostic aid29 липня 2026
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Попередні статті
Haiku OS: Операційна система, що відмовилася стати Linux
Haiku OS, спадкоємиця BeOS, пропонує унікальний підхід до дизайну ОС, відрізняючись від Linux та інших систем, і є легкою та функціональною альтернативою.
Microsoft представила архітектуру маршрутизації LLM-трафіку для AI-агентів на AKS
Microsoft випустила еталонну архітектуру для маршрутизації трафіку AI-агентів на Azure Kubernetes Service, що оптимізує витрати та продуктивність за допомогою трирівневого підходу.
Intuit Credit Karma використовує гібридний ШІ для точних фінансових рішень
Intuit Credit Karma відходить від загальних чат-ботів, впроваджуючи спеціалізовані ШІ-асистенти, що поєднують детерміновані фінансові розрахунки з генеративним ШІ.
Наступні статті
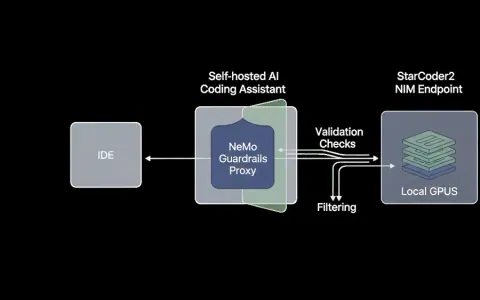
Самостійне розміщення перевіреного AI-асистента для кодування з NVIDIA NeMo Guardrails
NVIDIA пропонує рішення для самостійного розміщення перевіреного AI-асистента для кодування, що вирішує проблеми безпеки, ризиків ланцюга поставок та відстеження дефектів у чутливих середовищах.
Критична вразливість у Ruby on Rails дозволяє читати файли сервера через завантаження зображень
Виявлено критичну вразливість CVE-2026-66066 в Active Storage Ruby on Rails, що дозволяє неаутентифікованим зловмисникам читати довільні файли з серверів через спеціально створені завантаження зображень.
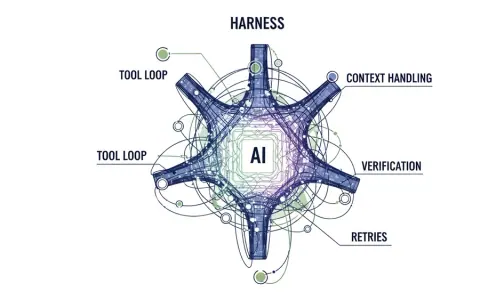
Не модель, а «обв'язка»: що насправді визначає вартість та ефективність AI-агентів для кодування
Вартість та ефективність AI-агентів для кодування залежать не стільки від базової моделі, скільки від її «обв'язки» — механізмів обробки контексту, повторних спроб та верифікації.