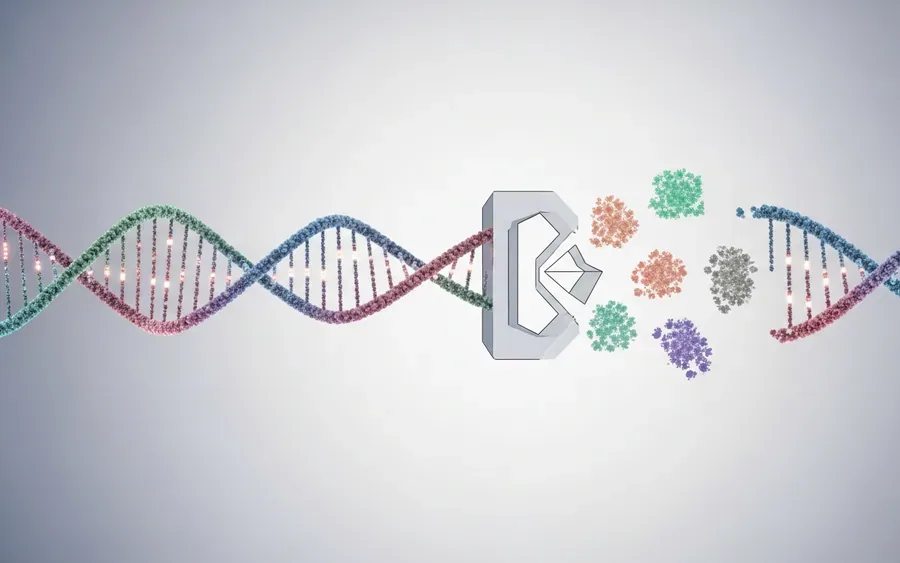
Покращене прогнозування ризику діабету 1 типу
Дослідники розробили модель машинного навчання під назвою T1GRS, яка значно покращила прогнозування ризику діабету 1 типу (T1D) порівняно з попередніми генетичними показниками ризику (GRS) серед європейців. Ця модель використовує 160 генетичних сигналів ризику, і її покращена здатність до прогнозування була особливо помітною у людей без високоризикових гаплотипів людського лейкоцитарного антигену (HLA).
Хоча модель T1GRS була навчена на варіантах, ідентифікованих у осіб європейського походження, вона показала порівнянні результати з показниками, специфічними для африканських американців, при тестуванні на цій групі. Крім того, T1GRS виявила чотири різні генетичні підтипи T1D, які демонструють значні відмінності у віці початку захворювання та частоті ускладнень, пов'язаних з діабетом.
Методологія дослідження
Діабет 1 типу значною мірою успадковується, головним чином через гени HLA класу I та II, але також за участю багатьох інших генів. Для ідентифікації генетичних сигналів ризику, пов'язаних з T1D, дослідники провели повногеномний асоціативний аналіз (GWAS) за участю 817 718 осіб європейського походження (20 355 пацієнтів з T1D та 797 363 особи без діабету). Також було проведено аналіз тонкого картування в локусі головного комплексу гістосумісності (MHC) за участю 29 746 осіб.
Модель T1GRS була навчена з використанням генетичних варіантів, виявлених за цими сигналами. Валідація моделі відбулася на незалежних когортах європейців та африканських американців, що включали пацієнтів з T1D, T2D та осіб без діабету. Для виявлення клінічних характеристик, пов'язаних з генетичними підтипами, було проведено кластерний аналіз на основі ознак, отриманих з T1GRS, який потім був реплікований в незалежній когорті валідації.
Ключові висновки та підтипи
Загалом було ідентифіковано 160 сигналів ризику в 97 локусах ризику, а також у локусі MHC. Модель T1GRS, заснована на градієнтному бустингу, була побудована з використанням 199 варіантів (102 не-MHC та 97 MHC варіантів) і навчена у двох формах: одна включала генетичні варіанти, стать та основні компоненти походження, інша – лише генетичні варіанти. Також були розроблені окремі підмоделі лише для MHC та лише для не-MHC.
T1GRS продемонструвала покращену класифікацію T1D порівняно зі звичайною моделлю GRS у 29 746 осіб європейського походження. Модель також виявила 154 пари варіантів зі значними нелінійними взаємодіями, що вказує на її покращений потенціал для прогнозування ризику T1D.
Особи були розділені на чотири генетичні підтипи: MHC-залежний, MHC-збагачений, T-клітинно-збагачений та панкреатично-збагачений. Кожен підтип характеризувався різними ключовими генами та клітинними сигналами. Ці групи показали різні клінічні патерни: MHC-пов'язані підтипи розвивали T1D раніше, тоді як панкреатично-збагачений підтип мав пізніший початок, але вищі показники ниркових, неврологічних та серцевих ускладнень.
Значення та обмеження
Автори дослідження підкреслюють цінність поєднання результатів генетичних асоціативних досліджень з методами машинного навчання для покращення прогнозування складних захворювань. Дослідження було проведене під керівництвом Керолін МакГрейл, Тімоті Дж. Сірса та Емілі Н. Гріффін з Каліфорнійського університету в Сан-Дієго та опубліковане в Nature Genetics.
Серед обмежень дослідження зазначається, що точне визначення T1D за електронними медичними записами та лабораторними вимірюваннями залишається викликом у популяційних біобанках. Оскільки T1D є складним захворюванням з генетичними та екологічними компонентами, існують невід'ємні обмеження щодо прогностичної здатності лише генетичних даних. Дослідження асоціацій не розглядало широко рідкісні варіанти ризику, які могли б ще більше покращити прогнозування.
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Що це означає для розробників
Для розробників, що працюють у галузі біоінформатики та машинного навчання для геноміки, ця новина вказує на ефективність інтеграції генетичних асоціативних досліджень з ML-моделями для покращення прогнозування складних захворювань. Це може стимулювати розробку нових алгоритмів та інструментів для більш точної ідентифікації генетичних ризиків та підтипів захворювань.
Ключові факти
-
Модель машинного навчання T1GRS покращила прогнозування ризику діабету 1 типу (T1D) порівняно з попередніми генетичними показниками ризику (GRS) у європейців.
-
T1GRS використовує 160 генетичних сигналів ризику.
-
Покращене прогнозування було особливо помітним у людей без високоризикових гаплотипів HLA.
-
Модель, навчена на варіантах європейського походження, показала порівнянні результати в африканських американців.
-
T1GRS виявила чотири різні генетичні підтипи T1D зі значними відмінностями у віці початку захворювання та частоті ускладнень.
Додайте Voydevich.com у бажані джерела Google, щоб частіше бачити наші новини в пошуку.
Джерело
MedscapeEdited by Shrabasti Bhattacharya
Machine Learning Model Boosts Genetic Prediction of T1D Risk31 липня 2026
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Попередні статті
Goldman Sachs Asset Management запускає ШІ-платформу AlphaAI для інвестицій
Goldman Sachs Asset Management представила AlphaAI, нову інвестиційну платформу на базі штучного інтелекту, очікуючи, що ШІ стане ключовим рушієм прибутковості.
Perplexity випустила Numbat для моніторингу ризикованих AI-агентів кодування
Perplexity представила Numbat, відкритий інструмент безпеки для моніторингу AI-агентів кодування на робочих станціях. Він виявляє та блокує небезпечну поведінку, реагуючи на зростаючі ризики.
Paper залучає $34 млн для конкуренції з Figma в еру AI-агентів
Стартап Paper залучив $34 млн у раунді Серії А, довівши загальне фінансування до $38.5 млн. Компанія стверджує, що її підхід на основі HTML/CSS та інтеграція з AI-агентами перевершить пропрієтарні формати.
Наступні статті
Perplexity AI відкриває вихідний код Numbat для захисту локальних агентів ШІ-кодування
Perplexity AI представила Numbat, легкий шар для виявлення та реагування, що забезпечує локальні засоби захисту та криміналістику для робочих процесів розробників з використанням ШІ.
Аудит коду за допомогою ШІ: GlobaLeaks виявив 29 вразливостей за $3140
Аудит платформи GlobaLeaks за допомогою ШІ виявив 29 вразливостей, 12 проблем DoS та 42 рекомендації, демонструючи, як LLM роблять перевірку коду швидшою та доступнішою.
Quantum Solutions збільшує продаж Ethereum для фінансування центрів обробки даних ШІ
Японська фірма Quantum Solutions збільшила ліміт продажу Ethereum та реалізувала частину своїх активів для фінансування бізнесу центрів обробки даних для інфраструктури ШІ.