
Вимірювання енергоспоживання локальних LLM на Apple Silicon
Недавнє дослідження, проведене на Mac Studio з чипом M3 Ultra та 96 ГБ уніфікованої пам'яті, виявило несподівані закономірності у вартості запуску локальних великих мовних моделей (LLM). Вимірювання, що враховували кожен ват енергії, показали, що найдорожчою в експлуатації виявилася не найбільша модель, а модель середнього розміру. Зокрема, 120-мільярдна модель виявилася приблизно в п'ять разів дешевшою за токен, ніж модель, яка становить чверть її розміру.
Методологія вимірювання
Для отримання точних даних було розроблено інструмент TokenWatt — проксі, сумісний з OpenAI, спеціально для Apple Silicon. Він вимірює енергоспоживання системи на кристалі (SoC) через інтерфейс Apple IOReport, віднімаючи базове споживання в режимі очікування, щоб визначити маргінальну вартість запиту. Усі вимірювання були відкалібровані за допомогою зовнішнього ваттметра Shelly Plug US Gen4, що забезпечило точність даних з похибкою від ±2.6% до ±4.5%. Вартість електроенергії була встановлена на рівні $0.31/кВт·год.
Тестування проводилося в режимі безперервної генерації токенів, що дозволило отримати максимально відтворювані результати при повному завантаженні графічного процесора.
Результати: Параметри не визначають вартість
Дослідження охопило п'ять моделей, що вміщуються в 96 ГБ уніфікованої пам'яті, від 4-мільярдної щільної моделі до 120-мільярдної моделі типу Mixture-of-Experts (MoE). Вартість розраховувалася за мільйон згенерованих токенів:
- Qwen3.5-4B (щільна): $0.063/1M токенів
- Qwen3.6-35B-A3B (MoE): $0.087/1M токенів
- Qwen3-Coder-Next (~80B MoE): $0.103/1M токенів
- gpt-oss-120b (120B MoE): $0.109/1M токенів
- Qwen3.6-27B (щільна): $0.554/1M токенів
Найдорожчою виявилася 27-мільярдна щільна модель, яка коштує в 5-9 разів дорожче за інші, включно з більшими моделями. Це підтверджує, що кількість параметрів не є надійним показником вартості запуску моделі.
Чому великі моделі можуть бути ефективнішими
Основна причина такої різниці у вартості полягає у співвідношенні споживаної потужності до пропускної здатності (ватти, поділені на кількість токенів за секунду). 27-мільярдна щільна модель споживає найбільше енергії (138 Вт) і генерує найменше токенів (21.5 токенів/с). Це відбувається тому, що для генерації кожного токена щільна модель повинна зчитувати всі свої 28 ГБ ваг з пам'яті, що призводить до великого обсягу передачі даних, низької швидкості та високого енергоспоживання.
Моделі Mixture-of-Experts (MoE), такі як 120-мільярдна gpt-oss-120b, працюють інакше. Хоча вони мають 120 мільярдів параметрів, для кожного токена активується лише близько 5 мільярдів. Це означає, що зчитується лише невелика частина з 59 ГБ ваг, що призводить до меншого обсягу передачі даних, вищої швидкості (74 токени/с) та меншого енергоспоживання (94 Вт). Квантування (4-6 біт проти 8 біт у щільних моделей) додатково підвищує ефективність.
Реальний трафік та особливості Apple Silicon
Дані, зібрані протягом місяця реального використання (понад 6300 запитів), показали, що 27-мільярдна щільна модель коштувала приблизно в десять разів дорожче за токен, ніж моделі MoE. Хоча реальний трафік є менш стабільним і підвищує вартість за токен у 2-3 рази порівняно з бенчмарками, загальна закономірність зберігається: щільна модель середнього розміру залишається найдорожчою.
Особливості Apple Silicon включають:
- Постійне споживання енергії: Уніфікована пам'ять означає, що великі моделі, що знаходяться в пам'яті, створюють постійне навантаження, яке зростає з розміром моделі, а потім стабілізується на рівні близько 21 Вт.
- Обмеження пам'яті: 96 ГБ уніфікованої пам'яті є стелею; 120-мільярдна модель займає близько 59 ГБ, що разом з ОС та кешем KV наближається до практичного ліміту.
- Маргінальна вартість: Вимірювання стосуються лише маргінальної вартості електроенергії, не включаючи вартість самого обладнання (наприклад, Mac Studio M3 Ultra 96 ГБ коштує $5,299).
Висновок для розробників
Головний висновок полягає в тому, що при виборі локальної LLM для Apple Silicon слід орієнтуватися на пропускну здатність, а не на кількість параметрів. Добре квантована 120-мільярдна модель MoE може бути дешевшою та швидшою в роботі, ніж 27-мільярдна щільна модель, завдяки ефективнішому використанню уніфікованої пам'яті та архітектурі MoE. Важливо спочатку переконатися, що модель відповідає вимогам якості, а потім використовувати показники вартості та пропускної здатності для остаточного вибору.
Інструмент TokenWatt є відкритим вихідним кодом і доступний на GitHub, дозволяючи розробникам вимірювати власні моделі та тарифи.
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Що це означає для розробників
Розробникам, які працюють з локальними LLM на Apple Silicon, слід враховувати, що кількість параметрів моделі не є прямим показником її вартості запуску. Натомість, ключовими факторами є пропускна здатність та архітектура моделі (наприклад, MoE проти щільних моделей), оскільки вони впливають на обсяг даних, що передаються з пам'яті. Вибір добре квантованої моделі MoE може призвести до значно нижчих експлуатаційних витрат і вищої швидкості, навіть якщо вона має більше параметрів, ніж щільна модель.
Ключові факти
-
На Apple Silicon 120-мільярдна модель може бути приблизно в п'ять разів дешевшою за токен, ніж 27-мільярдна модель.
-
Вартість запуску локальних LLM на Apple Silicon залежить від пропускної здатності та обсягу даних, що передаються з пам'яті, а не від кількості параметрів.
-
Інструмент TokenWatt вимірює енергоспоживання SoC на Apple Silicon, відкалібрований за допомогою зовнішнього ваттметра.
-
27-мільярдна щільна модель є найдорожчою через високе енергоспоживання (138 Вт) та низьку пропускну здатність (21.5 токенів/с), оскільки вона зчитує всі 28 ГБ ваг для кожного токена.
-
Моделі Mixture-of-Experts (MoE) ефективніші, оскільки активують лише частину параметрів для кожного токена, зменшуючи обсяг передачі даних.
Додайте Voydevich.com у бажані джерела Google, щоб частіше бачити наші новини в пошуку.
Джерело
Towards Data ScienceJustin Stewart
How Much Does a Local LLM Actually Cost to Run? I Measured Every Watt on Apple Silicon28 липня 2026
Розібратися глибше
Усі гайдиЩо таке токен в LLM: повний гайд для розробників
Дізнайтеся, що таке токени у великих мовних моделях (LLM), як вони впливають на вартість та ліміти, а також як їх рахувати для оптимізації ваших запитів.
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Попередні статті
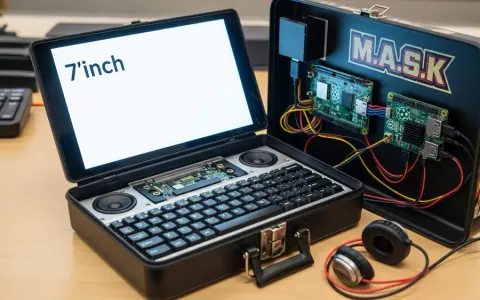
Ланчбокс M.A.S.K. перетворили на кібердек з локальним LLM
Ентузіаст створив портативний кібердек, вбудувавши Raspberry Pi 5 та 7-дюймовий сенсорний екран у вінтажний ланчбокс M.A.S.K. Пристрій працює з локальною 3-мільярдною моделлю LLM без підключення до інтернету.
Єврокомісія представила інституційний LLM та бенчмарк для мов ЄС
Європейська Комісія випустила відкриту велику мовну модель (LLM) та новий бенчмарк EU MMLU, розроблені для підтримки 24 офіційних мов ЄС та зміцнення європейського суверенного ШІ.
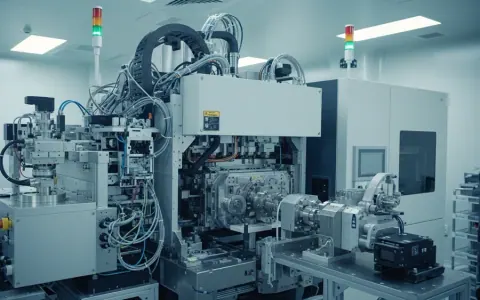
Китай заявляє про прорив у виробництві DUV-машин: чи похитне це домінування ASML?
Повідомлення про масове виробництво Китаєм критично важливих DUV-машин викликало падіння акцій ASML, але аналітики сумніваються, що це суттєво вплине на лідера ринку.
Наступні статті
Дослідження: Спеціалізований клінічний ШІ поступається загальним моделям у медичних питаннях
Нове дослідження NYU Langone Health показало, що клінічні великі мовні моделі працюють гірше, ніж загальні моделі, викликавши бурхливу реакцію в спільноті.
Intuit Credit Karma використовує гібридний ШІ для точних фінансових рішень
Intuit Credit Karma відходить від загальних чат-ботів, впроваджуючи спеціалізовані ШІ-асистенти, що поєднують детерміновані фінансові розрахунки з генеративним ШІ.
Microsoft представила архітектуру маршрутизації LLM-трафіку для AI-агентів на AKS
Microsoft випустила еталонну архітектуру для маршрутизації трафіку AI-агентів на Azure Kubernetes Service, що оптимізує витрати та продуктивність за допомогою трирівневого підходу.