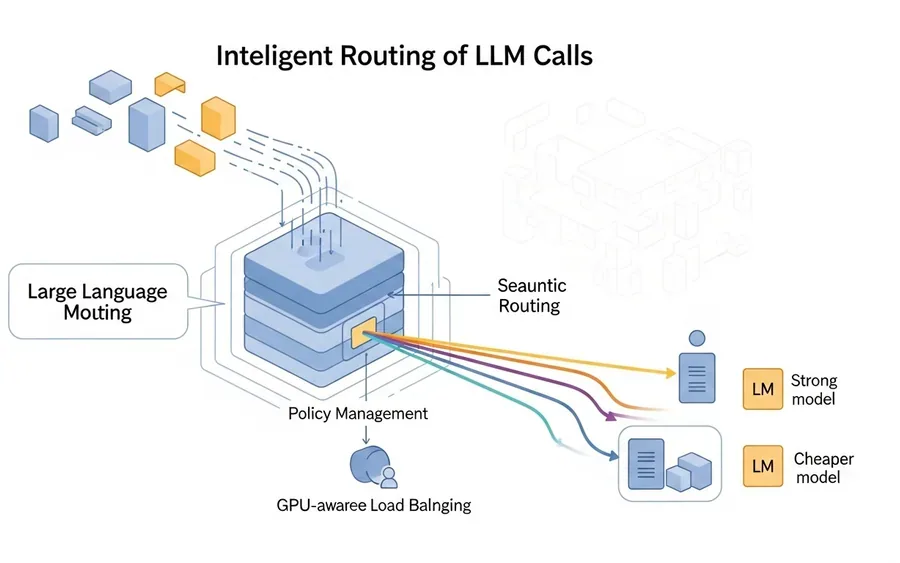
Microsoft представила еталонну архітектуру для маршрутизації трафіку агентів на Azure Kubernetes Service (AKS). Ця архітектура вирішує проблему, розбиваючи її на три ключові рішення: яка модель відповідає на запит, як керується запит і яка GPU-репліка його обробляє.
Проблема агентних робочих навантажень
Архітектура розроблена спеціально для агентних робочих навантажень, а не для чатів. Одне завдання агента може генерувати сотні викликів до великих мовних моделей (LLM) у циклі «планування-дія-спостереження». Більшість цих викликів (наприклад, заповнення аргументів інструменту, відповідь «так/ні», узагальнення) не потребують використання найсучасніших моделей. Відправлення кожного виклику до топової моделі збільшує витрати та затримки, особливо при довгих циклах. Простий балансувальник навантаження типу round-robin може погіршити ситуацію, ставлячи в чергу невелике завершення за великим попереднім заповненням на зайнятому GPU-поді, тоді як інший вільний под залишається невикористаним.
Трирівнева архітектура
Запропонована архітектура поєднує три основні компоненти, які підключаються до однієї OpenAI-сумісної кінцевої точки:
- RouteLLM: Для семантичної маршрутизації, що визначає, яка модель відповідає на запит.
- agentgateway: Як AI-проксі, що керує викликами.
- Kubernetes Gateway API Inference Extension (Endpoint Picker): Для балансування навантаження та вибору GPU-репліки.
Деталі компонентів
RouteLLM перевіряє запит і прогнозує, чи може дешевша модель відповідати якості відповіді сильнішої моделі. Він використовує маршрутизатор на основі матричної факторизації, навчений на даних людських переваг. У тестуванні RouteLLM досяг близько 95% якості GPT-4 за MT-Bench, відправляючи лише близько 26% викликів до GPT-4. Це дозволило заощадити до 85% витрат порівняно з маршрутизацією всіх викликів до сильної моделі. Microsoft зазначає, що ця цифра не є універсальною і залежить від конкретної пари моделей, використаної для навчання RouteLLM. Користувачам необхідно калібрувати поріг на основі фактичного трафіку.
agentgateway — це проксі з відкритим вихідним кодом, який працює з OpenAI. Він керує політиками, такими як автентифікація, обмеження швидкості для кожного агента, відстеження витрат та захисні механізми, не перевіряючи при цьому зміст запитів. Для самостійно розміщених рішень agentgateway викликає Endpoint Picker безпосередньо через ext-proc, дозволяючи обійти окремий шлюз Gateway API. Сильний шлях маршрутизується до Azure OpenAI через AI-бек-енд в agentgateway, тоді як слабкий шлях направляється до подів, що обслуговуються KAITO, через сервісний бек-енд.
Kubernetes Gateway API Inference Extension (Endpoint Picker) перевіряє поточний стан GPU, аналізуючи заповненість KV-кешу vLLM та глибину черги. Це допомагає йому вирішити, яка репліка обраної моделі обробить запит. KAITO надає пули GPU-вузлів за потребою та запускає vLLM, надаючи метрики, такі як vllm:num_requests_waiting та vllm:kv_cache_usage_perc, які використовує Endpoint Picker.
Інфраструктура та моніторинг
Три шари з відкритим вихідним кодом працюють у кластері AKS. Обслуговування KAITO, Azure OpenAI та стек спостереження Prometheus/Grafana керуються Azure. Azure Managed Prometheus та Grafana збирають метрики маршрутизації та витрат agentgateway, а також метрики GPU vLLM для комплексного огляду.
Гнучкість та зрілість
Microsoft зазначає, що її маршрутизатор моделей Foundry є керованою версією семантичного шару RouteLLM, що зручно для команд, які не бажають самостійно керувати маршрутизатором. Однак наразі немає керованої опції для розміщення Endpoint Picker з урахуванням GPU; він повинен працювати в кластері. Компоненти архітектури є відносно новими, і назви полів можуть змінюватися між релізами. Рішення було перевірено на AKS у середині 2026 року з Inference Extension v1.0.0 та agentgateway v1.3.1. Команди можуть впроваджувати цю архітектуру поступово, обираючи лише необхідні компоненти залежно від своїх потреб.
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Що це означає для розробників
Розробники можуть використовувати цю архітектуру для оптимізації витрат та продуктивності своїх AI-агентів на AKS, інтегруючи RouteLLM для семантичної маршрутизації, agentgateway для керування політиками та Inference Extension для ефективного використання GPU. Це дозволяє їм вибирати між керованими та самостійно розміщеними компонентами, адаптуючи рішення до своїх вимог.
Ключові факти
-
Microsoft випустила еталонну архітектуру для маршрутизації трафіку AI-агентів на Azure Kubernetes Service (AKS).
-
Архітектура вирішує проблему трьома ключовими виборами: яка модель відповідає, як керується виклик, яка GPU-репліка обробляє.
-
Вона поєднує Kubernetes Gateway API Inference Extension, agentgateway та RouteLLM, які підключаються до однієї OpenAI-сумісної кінцевої точки.
-
RouteLLM використовує матрично-факторизаційний маршрутизатор, навчений на даних людських переваг, для семантичної маршрутизації.
-
RouteLLM досяг ~95% якості GPT-4 за MT-Bench, відправляючи ~26% викликів до GPT-4, що дозволило заощадити до 85% витрат.
Додайте Voydevich.com у бажані джерела Google, щоб частіше бачити наші новини в пошуку.
Джерело
InfoQClaudio Masolo
Microsoft Three-Layer LLM Routing Architecture for AI Agents on AKS29 липня 2026
Розібратися глибше
Усі гайдиЩо таке AI-агент: повний гайд для розробників
Дізнайтеся, що таке AI-агент, як він працює, з чого складається та чим відрізняється від асистента чи чат-бота. Ознайомтеся з типами та прикладами AI-агентів.
Реклама · cv-finder.com
Покажіть AI-стек у резюме без зайвого шуму
AI-асистент CV-Finder допоможе описати LLM/ML-проєкти через результати.
Попередні статті
Intuit Credit Karma використовує гібридний ШІ для точних фінансових рішень
Intuit Credit Karma відходить від загальних чат-ботів, впроваджуючи спеціалізовані ШІ-асистенти, що поєднують детерміновані фінансові розрахунки з генеративним ШІ.
Дослідження: Спеціалізований клінічний ШІ поступається загальним моделям у медичних питаннях
Нове дослідження NYU Langone Health показало, що клінічні великі мовні моделі працюють гірше, ніж загальні моделі, викликавши бурхливу реакцію в спільноті.

Вартість локальних LLM на Apple Silicon: 120-мільярдна модель дешевша за 27-мільярдну
Дослідження виявило, що на Apple Silicon вартість запуску локальних великих мовних моделей не залежить від кількості параметрів, а від пропускної здатності та архітектури моделі.
Наступні статті
Haiku OS: Операційна система, що відмовилася стати Linux
Haiku OS, спадкоємиця BeOS, пропонує унікальний підхід до дизайну ОС, відрізняючись від Linux та інших систем, і є легкою та функціональною альтернативою.
Машинне навчання для діагностики рідкісних пухлин: потенціал та виклики "ярликового навчання"
Дослідження показує, що машинне навчання може покращити діагностику рідкісних пухлин надниркових залоз, але вимагає ретельної перевірки на "ярликове навчання".
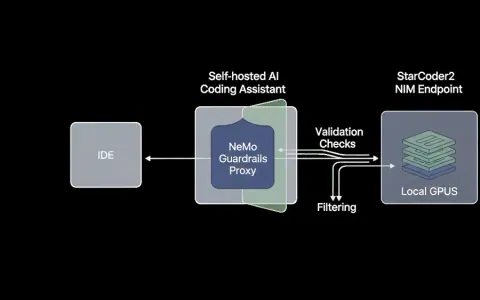
Самостійне розміщення перевіреного AI-асистента для кодування з NVIDIA NeMo Guardrails
NVIDIA пропонує рішення для самостійного розміщення перевіреного AI-асистента для кодування, що вирішує проблеми безпеки, ризиків ланцюга поставок та відстеження дефектів у чутливих середовищах.